Appearance
Codex CLI 配置参考
本页用于手动配置、模型参数说明和排障。日常使用默认推荐先看 CC Switch 统一配置。
配置方式一:CC Switch(默认推荐)
CC Switch 是最简单的配置方式,自动写入 config.toml 和 auth.json,无需手动编辑文件。完整步骤、渠道与模型对应关系见 CC Switch 统一配置。
配置步骤:
- 打开 CC Switch,框架选 Codex,点击"添加配置"
- 在预设供应商列表中点击
Micu(Base URL 已自动填入) - 填写 API Key(
sk-xxx) - 点击添加,应用后重启终端
令牌设置:创建或编辑 API 令牌时,请关闭「模型限制」,限制令牌可调用的模型有时会引发未知异常。
配置方式二:手动编辑配置文件
文件位置
| 系统 | config.toml | auth.json |
|---|---|---|
| Windows | C:\Users\<USERNAME>\.codex\config.toml | C:\Users\<USERNAME>\.codex\auth.json |
| macOS / Linux | ~/.codex/config.toml | ~/.codex/auth.json |
config.toml
toml
model_provider = "micu"
model = "gpt-5.6-sol"
model_reasoning_effort = "high"
disable_response_storage = true

[model_providers.micu]
name = "micu"
base_url = "https://www.micuapi.ai/v1"
wire_api = "responses"
requires_openai_auth = true
Codex 的 Base URL 需要
/v1后缀,与 Claude Code 不同。
1M 上下文配置
如果你当前使用的是支持长上下文的 Codex 接入方案,建议同时确认以下两项。注意:这两个参数必须写在顶层,不能写在 [model_providers.micu] 供应商配置下:
toml
model_context_window = 1000000
model_auto_compact_token_limit = 900000
含义分别是:
| 参数 | 作用 |
|---|---|
model_context_window | 将可用上下文窗口设为 1,000,000 |
model_auto_compact_token_limit | 接近上限前提前触发压缩,避免对话直接撞满 |
如果你通过 CC Switch 一键写入配置,优先以 CC Switch 生成结果为准;只有在手动排障时才建议自己改 config.toml。
auth.json
json
{
  "OPENAI_API_KEY": "sk-xxx"
}
配置参数说明
| 参数 | 说明 | 可选值 |
|---|---|---|
model_provider | 模型提供商标识 | 自定义名称 |
model | 使用的模型 | 见下方模型列表 |
model_reasoning_effort | 推理深度 | low / medium / high |
disable_response_storage | 禁用响应存储 | true(推荐) |
wire_api | API 协议 | responses |
支持的模型
列表核对于 2026-09-13。后续以 模型广场 为准。
| 模型 | 可用分组 | 用途 |
|---|---|---|
gpt-5.6-sol | vip_2 / vip_2_cc | 主会话模型 |
gpt-6-astra | vip_2 / vip_2_cc | 主会话模型 |
codex-auto-review | vip_2 | 后台审查模型 |
自动审批与 LUNA 限速
目前 LUNA(gpt-5.6-luna)有全局限速,且本次查询未列入 vip_2 / vip_2_cc 的可选模型。若客户端后台自动审批仍请求 LUNA,建议关闭自动审批;如果需要保留,则将审批模型映射到当前分组可用的其他模型。
方式一:关闭审批请求
在 Codex 桌面端中,按截图中的编号操作:
- 搜索设置:打开设置,在左侧搜索框输入「审批」。
- 进入配置:点击搜索结果中的「从不请求审批」。
- 展开批准策略:在「配置」→「智能体默认设置」中,点击「批准策略」下拉框。
- 选择从不请求审批:将策略设为「从不请求审批」,然后新建会话再试。
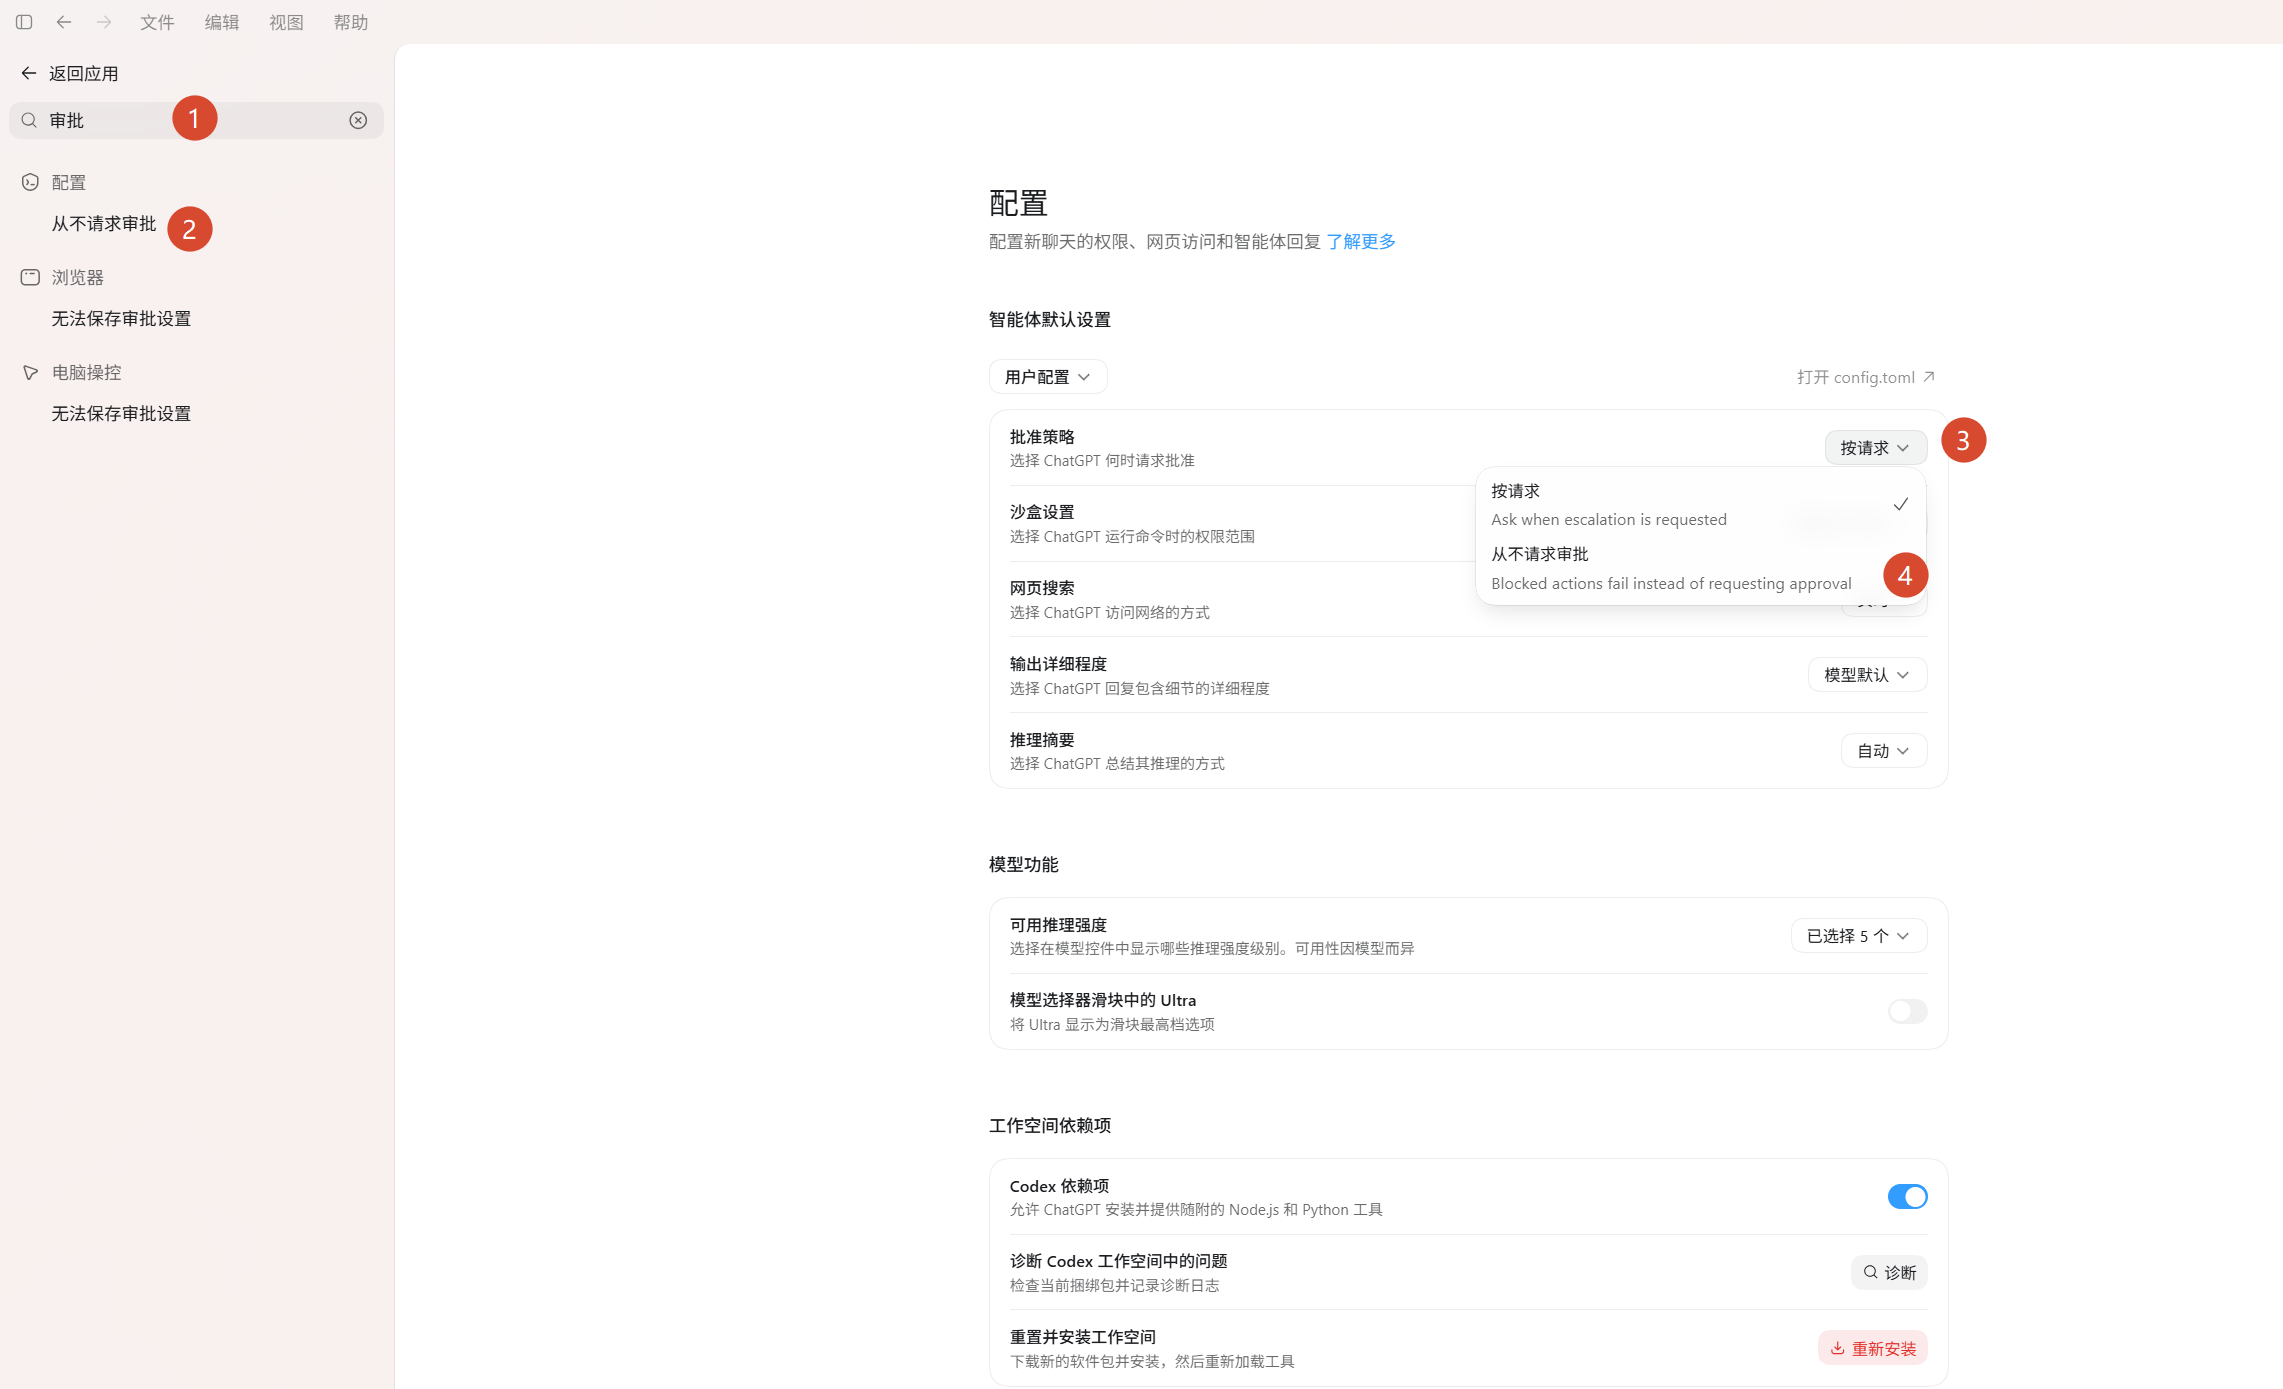
「从不请求审批」表示受限操作会直接失败,不再发起审批请求;该选项不会自动放宽沙盒权限。
方式二:保留自动审批并映射模型
如果接入服务或代理支持模型映射,可将自动审批请求实际使用的模型映射到当前分组可用的其他模型,例如 vip_2 / vip_2_cc 可用的 gpt-5.6-sol。映射入口以所用服务或代理为准。
请针对审批请求使用的模型设置映射,仅修改主会话的 model 不能保证后台审批也改用同一模型。
常见问题
会话异常时创建聊天分支
如果使用 Codex 桌面端时出现会话异常,先新开一个会话测试。新会话正常时,再为原会话创建聊天分支:
- 右键当前会话:在左侧会话列表中,右键点击出现异常的会话。
- 展开分叉菜单:在右键菜单中选择「分叉」。
- 创建聊天分支:点击「创建聊天分支」,进入新分支后重试刚才的操作。
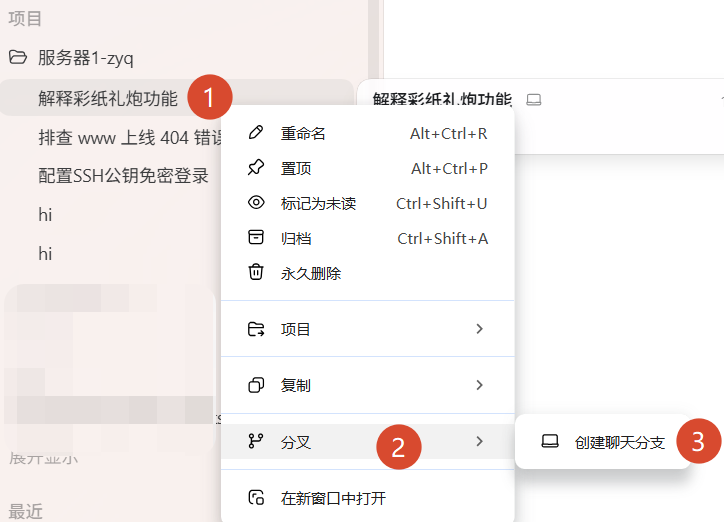
如果新会话也报错,继续核对配置;遇到请求发往官方地址的 401,按 配置或旧会话导致 401 的排查步骤 处理。
Base URL 格式问题
| 工具 | Base URL 格式 |
|---|---|
| Claude Code | https://站点地址(不带 /v1) |
| Codex | https://站点地址/v1(带 /v1) |
外接调用返回 403 block?
如果你不是直接使用官方默认链路,而是把 Codex 接到第三方平台、网关、自定义客户端或其他外接场景,除了 Base URL 和 API Key 之外,还要同时满足:
- 使用 Codex 对应分组(典型:
vip_2;其它 Codex / OpenAI 分组见 首页「令牌分组速查」) - 请求头中携带 Codex 对应的
User-Agent
示例:
json
{
  "Authorization": "Bearer sk-xxx",
  "User-Agent": "codex_cli_rs/0.77.0 (Windows 10.0.26100; x86_64) WindowsTerminal"
}
缺少对应 UA 时,常见报错就是 403 block 或 403 Forbidden。
如果你外接的不是 Codex,而是其他模型分组,例如国产模型分组 vip_4,也同样需要按对应类型补 User-Agent;不要把“只有 Codex 才要 UA”当成通用规则。
API Key 无效?
- 检查
~/.codex/auth.json中的 Key 是否正确 - 确认中转站余额充足
- 确认 Token 未过期
推理速度慢?
将 model_reasoning_effort 从 high 改为 medium 或 low,响应速度可显著提升。
同时使用 Claude Code 和 Codex?
两者配置文件独立,互不冲突。使用 CC Switch 可统一管理:
- Claude Code →
~/.claude/settings.json - Codex →
~/.codex/config.toml+~/.codex/auth.json
外接分组与 UA 的统一说明见 外接调用 User-Agent 说明。